7月31日,深圳职业技术大学西丽校区教学楼内键盘声此起彼伏。来自长沙商贸旅游职业技术学院的29名骨干教师,正围坐在屏幕前专注调试Python代码——这是第二期“双高”产教虚拟教研室“数据采集与预处理”高阶研修班第六天的课程现场,主题聚焦“Python网络数据采集与Scrapy工程化实战”。与传统的“台上讲、台下记”培训不同,这场课从一开始就带着鲜明的“产线味”。
把课堂搬进“数据工厂”
当天上午,深职大人工智能学院的教师团队没有直接翻开PPT逐页讲解语法,而是抛出了一道“真问题”:如果要为餐饮企业提供一份区域竞品菜品热度分析报告,数据从哪里来?
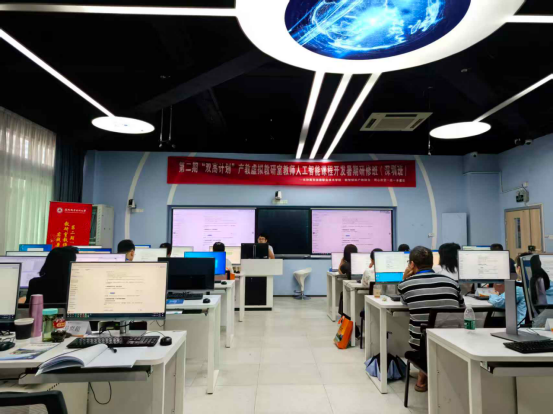
图1:深职大专家通过案例为大家演示爬取静态网页技术
这个问题瞬间把参训教师拉入了真实工作场景。围绕这一任务,讲师团队反向拆解知识链条——从HTTP请求与响应机制讲起,延伸到urllib、requests等工具选型,再过渡到Scrapy框架的五大核心组件协作逻辑。参训教师在理解“引擎—调度器—下载器—Spiders—Pipeline”数据流向的同时,同步完成了Anaconda环境搭建、依赖包管理与虚拟环境隔离等工程化配置。
“以前觉得爬虫就是写几行requests.get(),今天才知道一个规范的Scrapy项目要考虑中间件顺序、并发控制、robots协议合规——这和工业级开发的思维是一致的。”参训教师丁晓丽在课间交流时感慨道。
在“攻防”中学会数据采集
下午的实操环节更像一场“红蓝对抗”。深职大讲师团队提前部署了多套含反爬机制的模拟站点,参训教师分组扮演“数据采集方”,需要在限定时间内突破User-Agent校验、访问频率限制、动态页面加载等关卡,成功提取目标数据。
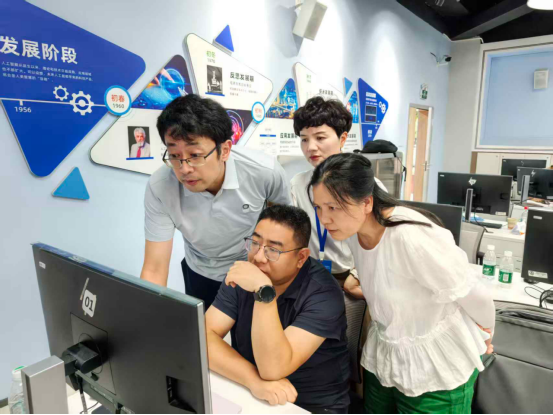
图2:实战模拟期间,深职大专家为各小组提供“一对一”指导
面对被拒绝的请求和频繁弹出的验证码,各小组在讲师巡回指导下尝试了随机UA池切换、下载延迟策略调整、XPath与CSS选择器混合定位等多种方案。当第一组成功将爬取到的结构化数据写入CSV文件时,教室里响起了一阵掌声。
这种“先遇阻、再破局”的设计并非刻意为难教师,而是深职大团队刻意的安排——“我们希望老师们回去后能告诉学生:技术不是背出来的,是在解决问题中长出来的。”
从“学会”到“教会”的最后一公里
课程的最后半小时,讨论焦点从代码转向了教案。参训教师围绕“如何将一个完整的Scrapy爬虫项目拆解为4~6课时的高职实验课”展开头脑风暴。有人提议用“校园公告栏信息采集“作为入门案例降低门槛,有人建议引入MongoDB存储让学生理解NoSQL数据库的应用场景。这些讨论产出将直接汇入“数字湘菜产教虚拟教研室”的课程资源库。
“这次研修最有价值的地方不在于学了几个库、写了几个爬虫,”带队老师人工智能学院院长刘锦峰总结道,“而在于我们看到了一套完整的‘产业技术→教学模块’的转化路径,这对我们后续建设烹饪工艺与营养专业群的数智化课程非常关键。”
据悉,本期暑期研修班将持续至8月9日,后续还将围绕机器学习模型部署、可视化大屏开发等主题继续展开深度实训。
通讯员:易世超
